De ChatGPT aux agents : votre catalogue est-il visible là où vos usagers cherchent ?
Pour beaucoup d'entre nous, l'intelligence artificielle se résume encore à ChatGPT : une fenêtre où l'on pose une question, un peu comme dans un moteur de recherche. Cette image est déjà dépassée. En quatre ans, l'IA a changé de nature et ces évolutions concernent directement les bibliothèques et leurs catalogues.
Petit retour sur les étapes qui nous ont menés jusqu'ici.
1. L'IA qui parle : les chatbots (fin 2022 – 2023)
Le 30 novembre 2022, OpenAI ouvre ChatGPT au grand public. On écrit une question, il répond. Il sait rédiger, résumer, traduire, expliquer. D'autres assistants suivent, comme Claude d'Anthropic.
À cette époque, tout repose sur la formulation de la question, le fameux « prompt ». Surtout, ces assistants sont coupés du monde : ils ne consultent ni le web en direct, ni vos fichiers, ni votre catalogue. Ils répondent à partir de ce qu'ils ont appris, avec le risque d'inventer des références qui n'existent pas, ce que beaucoup de bibliothécaires ont pu constater.
2. L'IA qui se connecte (2023 – 2024)
Les assistants commencent à aller chercher l'information ailleurs : recherche sur le web, lecture de documents, accès à des services en ligne. L'IA s'intègre aussi dans les logiciels du quotidien (messagerie, traitement de texte, outils de recherche). Elle n'est plus seulement une page qu'on visite, elle devient une fonction présente partout.
3. Une prise standard pour les données : le MCP (fin 2024 – 2025)
En novembre 2024, Anthropic publie le Model Context Protocol (MCP), un standard ouvert rapidement adopté par d'autres acteurs.
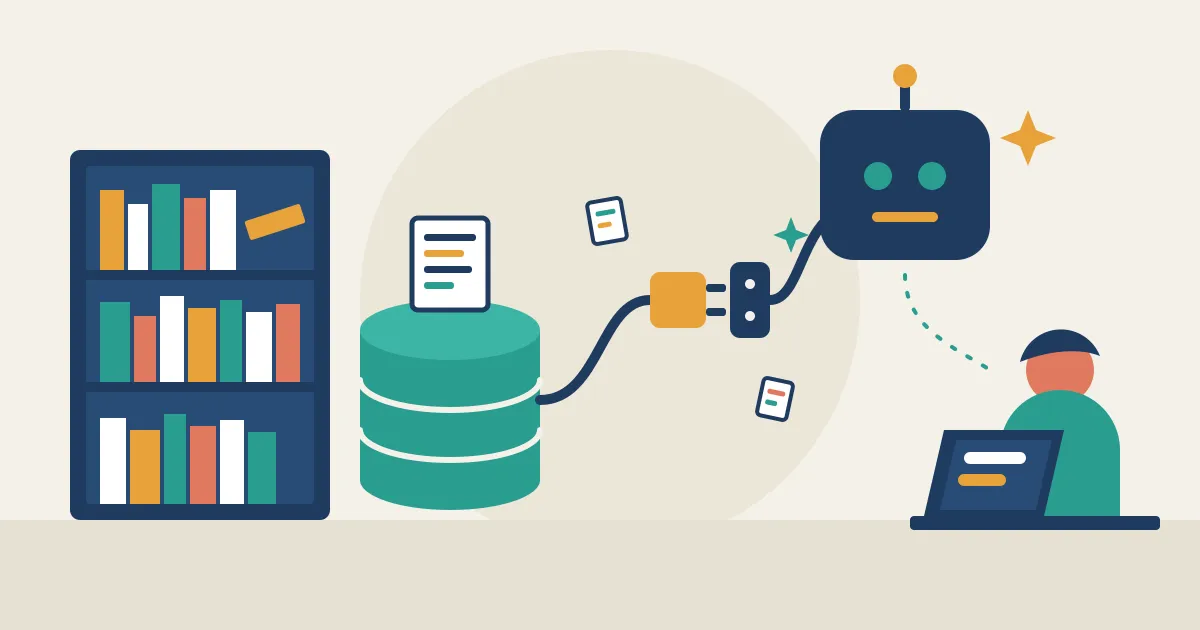
L'idée est simple : on peut le voir comme une prise universelle. Un service (une base de données, un logiciel, un catalogue) propose un « serveur MCP » et n'importe quel assistant compatible peut s'y brancher pour interroger ce service avec des outils adaptés : chercher, filtrer, récupérer des notices dans un format structuré.
Pour une bibliothèque, cela signifie qu'un usager pourrait interroger votre catalogue depuis son propre assistant, celui qu'il utilise déjà tous les jours, sans passer par l'OPAC.
4. L'IA qui agit : les agents (2025)
L'étape suivante est celle des agents. On ne pose plus une question, on confie une tâche. L'agent planifie, consulte plusieurs sources, compare, corrige et poursuit jusqu'au résultat.
Un exemple : un étudiant demande à son assistant de « préparer une bibliographie sur l'histoire des jardins ouvriers, avec les ouvrages disponibles dans les bibliothèques de ma ville ». L'agent va chercher lui-même dans les sources auxquelles il a accès. Si votre catalogue n'en fait pas partie, vos collections n'apparaîtront tout simplement pas dans la réponse.
5. L'IA encadrée : les harnais (2025 – aujourd'hui)
Pour que ces agents soient fiables sur des tâches longues, on les entoure d'un harnais (harness) : des règles, de la mémoire, des permissions, des outils autorisés et des mécanismes de vérification. C'est ce cadre qui détermine ce que l'agent peut faire, où il peut aller chercher l'information et avec quelle fiabilité.
Le fil conducteur
En résumé, l'IA a d'abord parlé, puis elle s'est connectée, puis elle a commencé à agir et elle est aujourd'hui encadrée pour agir de manière fiable.
À chaque étape, une même question devient plus importante : à quelles sources l'IA a-t-elle accès ?
Ce que cela change pour les bibliothèques
Pendant des années, la question était : comment faire venir les usagers sur notre OPAC ? Elle se déplace. De plus en plus d'usagers, notamment les étudiants et les chercheurs, commencent leurs recherches dans un assistant d'IA. La question devient alors : notre catalogue est-il accessible depuis ces outils ?
Une ressource absente de ces environnements risque de devenir invisible, même si elle est parfaitement décrite dans Koha.
Trois points méritent l'attention :
- Les OPAC sont faits pour les humains. Faire lire des pages web à un programme (le « web scraping ») fonctionne mal et sollicite fortement le serveur. Depuis 2025, les robots des entreprises d'IA aspirent massivement les OPAC pour alimenter leurs modèles, au point de ralentir ou de saturer de nombreux serveurs Koha. Les IA ont besoin de points d'accès prévus pour les machines.
- Koha dispose déjà de portes d'entrée pour les machines. L'API REST, SRU/Z39.50 ou encore OAI-PMH permettent d'exposer les données de manière structurée. Un serveur MCP peut s'appuyer sur ces briques pour offrir un accès adapté aux assistants d'IA.
- La qualité des métadonnées compte plus que jamais. Une IA ne trouve et ne restitue correctement que ce qui est bien décrit. Le travail de catalogage, d'indexation et de normalisation reste la base de tout.
Et vous ?
Quelques questions à vous poser dès maintenant :
- Vos usagers utilisent-ils déjà des assistants d'IA pour leurs recherches ?
- Votre catalogue est-il interrogeable par une machine et dans quelles conditions ?
- Souhaitez-vous maîtriser la manière dont vos données sont exposées aux IA, ou laisser d'autres le faire à votre place ?
Ce n'est pas une question purement technique. C'est une question de positionnement : faire en sorte que les collections des bibliothèques restent présentes là où se font aujourd'hui les recherches.